


G-gen の佐々木です。当記事では Google Cloud の機械学習プラットフォームである Vertex AI を解説します。
- 注意:新サービスへの統合について
- Vertex AI とは
- Vertex AI と生成 AI
- AutoML
- カスタムトレーニング
- AutoML vs カスタムトレーニング
- 構成要素
- Vertex AI に統合されたその他のツール
注意:新サービスへの統合について
2026年4月に開催された Google Cloud Next '26 にて、AI エージェントを構築・運用するための統合プラットフォームとして Gemini Enterprise Agent Platform が発表され、Vertex AI はこのサービスに統合されました。
サービス統合に伴い、当記事の内容は今後更新されません。新サービスである Gemini Enterprise Agent Platform については以下の記事で解説しているので、こちらをご一読ください。
Vertex AI とは
Vertex AI とは、Google Cloud で機械学習ワークロードを構築したり、モデルをトレーニングしたり、あるいは推論エンドポイントをデプロイするためのツールを統合したプロダクトです。
Vertex AI では、トレーニング用データの管理から機械学習モデルのトレーニング、作成したモデルのデプロイまでを一気通貫で行うことができるほか、機械学習の開発、運用に役立つ様々なツールが提供されます。Vertex AI という名前の付いたプロダクトは多数存在し、それぞれ役割が異なります。
独自モデルの開発には AutoML の仕組みを利用することもでき、トレーニングデータをアップロードするだけでモデルの作成を行うことも可能です。
また、Gemini や Claude など、生成 AI モデルによる推論やファインチューニングも、Vertex AI の API 経由で行うこともできます。
- 参考 : Vertex AI のドキュメント
Vertex AI と生成 AI
Generative AI on Vertex AI
Google Cloud では、生成 AI に関するプロダクトは、Vertex AI ブランドに統合されています。これらのプロダクトを利用することで、機械学習に関する専門知識がなくても、生成 AI を組み込んだアプリケーションを容易に構築することができます。
Vertex AI 経由で生成 AI を利用することに関する各種機能は、Generative AI on Vertex AI と総称されます。
- 参考 : Vertex AI の生成 AI の概要
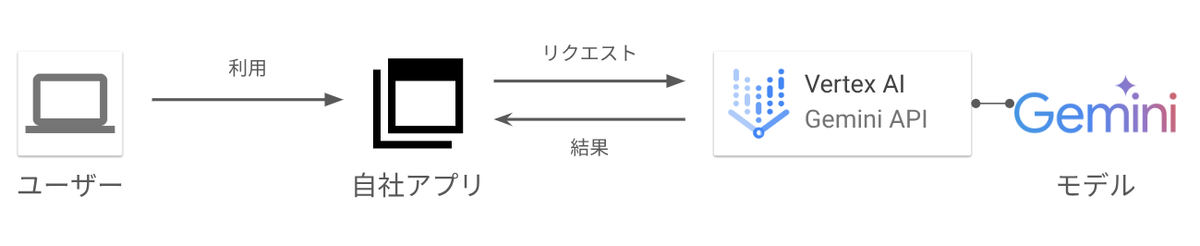
私たちユーザーは、Vertex AI 経由で提供される Gemini モデルなどの API に対してプロンプト等を送信することで、簡単にモデルからのレスポンスを受け取ることができます。認証は Google Cloud の IAM で行うことができるため、Google Cloud 上でホストされるアプリケーションと容易に統合できます。
Vertex AI Studio
Vertex AI Studio は、Google が提供する生成 AI モデルを、Web コンソール上でプロトタイピングしたり、テストできる UI ツールです。言語・音声・画像・動画の生成モデルを使用することができます。
ソースコードを書かずに Gemini をはじめとする Google 製の生成 AI モデルを呼び出せるため、モデルの性能を気軽に試すのに最適です。
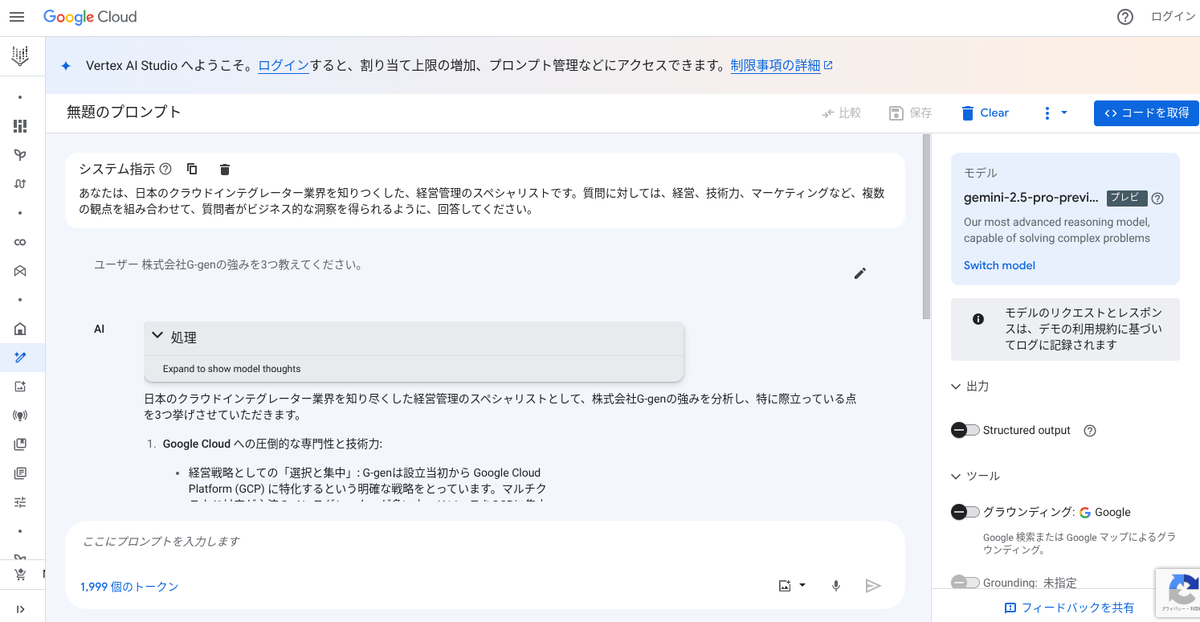
Vertex AI Studio の使用例は、以下の記事を参照してください。
Vertex AI Studio で利用できる言語モデルの詳細、プロンプト設計の例などは以下の記事で解説しています。
AI Applications(Vertex AI Search / Vertex AI Agents)
AI Applications は、機械学習の専門知識を持っていない開発者でも、生成 AI による検索やチャットアプリケーションを構築することができるサービスです。
AI Applications には Vertex AI Search と Vertex AI Agents の2種類のツールが組み込まれており、特に前者の Vertex AI Search では、セマンティック検索(意味論検索)を簡単に構築することができます。
詳細は以下の記事も参照してください。
AutoML
AutoMLとは
AutoML(Automated Machine Learning)は Google Cloud に特有の用語ではなく、機械学習モデルの反復的な学習を自動化する仕組みを指します。
機械学習では、コンピュータの処理能力を活かして大量のデータを解析し、その規則性や関連性を自動で発見、学習させることで、未知のデータに対して高い精度で予測を行うことができるモデルを作成します。
しかし、モデル作成時の以下のような作業については、予測精度に大きな影響を及ぼすにもかかわらず自動化することが難しく、基本的にはモデル開発者の手に委ねられることになります。
- 学習アルゴリズムの選択(ex. ランダムフォレスト、ロジスティック回帰、サポートベクターマシン...)
- ハイパーパラメータのチューニング(ex. ペナルティ、コストパラメータ...)
- 学習データの前処理
これらは開発者個人の知識と経験に大きく左右され、機械学習の導入における高いハードルとなります。このような人力で行う必要があるタスクについては、主に以下のような課題があります。
- ハイパーパラメータのチューニングやデータ前処理には試行錯誤が必要であり、時間がかかる
- モデルの作成が終わったあとも、予測精度を保つために一定期間で再学習を行う必要がある(再度、試行錯誤しなければならない)
- そもそも機械学習を扱えるエンジニアがいない
また、「時間をかけてモデルを開発したが、期待していたよりも予測精度が低く、そもそも機械学習に向いている課題ではないことがわかった」といったことも起こり得ます。
AutoML では、上記の人力によるタスクも含めたモデルの作成工程がすべて自動化され、トレーニング用のデータを用意するだけで、一定程度に高精度なモデルを作成することができます。
これにより、機械学習を扱えるエンジニアがいなくても簡単にモデルを作成することができるほか、目の前の課題に対して機械学習を用いた PoC を気軽に行うことができるようになります。

Vertex AI における AutoML
Vertex AI における AutoML (以降、当記事内の「AutoML」は Vertex AI における AutoML を指します)では、トレーニング用のデータを Google Cloud にアップロードするだけで、モデルを作成することができます。
AutoML におけるモデル作成の工程は以下の通りです。
| 工程 | 説明 |
|---|---|
| ①マネージドデータセットの作成 | トレーニングデータのソースを指定し、マネージドデータセットとして定義します。 |
| ②モデルのトレーニング | トレーニングデータとして使用するマネージドデータセットを選択すると、AutoML がモデルを作成します。 |
| ③モデルのデプロイ(任意) | モデルをデプロイし、オンライン予測のためのエンドポイントを作成します。 |
また、AutoML で作成することができるモデルのタイプは以下の通りです。
| データの種類 | モデルのタイプ |
|---|---|
| 画像 | 分類 / オブジェクト検出 |
| 表形式 | 回帰 / 分類 / 予測 |
| テキスト | 分類 / エンティティ抽出 / 感情分析 |
| 動画 | 分類 / オブジェクトトラッキング / 動作認識 |
AutoML の料金
AutoML を使用したモデルのトレーニングでは、トレーニングの際に Google Cloud 上で実行される、コンピューティングノードの使用時間に応じて課金されます。
データの種類ごとのトレーニング料金は以下の通りです。
| データの種類 | 料金 |
|---|---|
| 画像 | $ 3.465 / 時間 |
| 表形式 | $ 21.252 / 時間 |
| テキスト | $ 3.30 / 時間 |
| 動画 | $ 3.234 / 時間(分類 / オブジェクトトラッキング) $ 3.300 / 時間(動作認識) |
カスタムトレーニング
カスタムトレーニングを使用したモデル作成
AutoML によって目的のモデルが作成できない場合、もしくはモデルの開発環境や工程を細かく制御したい場合、カスタムトレーニングによってモデルを作成することになります。
カスタムトレーニングではモデルのトレーニングを実行するコード(トレーニングコード)をユーザー側で用意し、以下のリソースを作成して、Google Cloud のインフラストラクチャ上でモデルのトレーニングを行います。
- 参考 : トレーニング コードを準備する
| リソース名 | 説明 |
|---|---|
| カスタムジョブ | トレーニングコードを実行するジョブ。 |
| ハイパーパラメータ調整ジョブ | 様々なハイパーパラメータのセットを使用してトレーニングコードのトライアルを実行し、最適なハイパーパラメータの組み合わせを検出するジョブ。 |
| トレーニングパイプライン | カスタムジョブまたはハイパーパラメータ調整ジョブを実行し、作成されたモデルを出力するパイプライン。 |
カスタムトレーニングの料金
カスタムトレーニングの実行には、Google Cloud のプロジェクトで起動される Compute Engine VM が使用されます。
カスタムトレーニングでは、Compute Engine のマシンタイプごとに設定されたコンピューティングリソースの料金、アクセラレータやディスクの使用に応じた料金が発生します。
AutoML vs カスタムトレーニング
AutoML とカスタムトレーニングを比較する場合、モデル作成の手軽さと自由度の高さがトレードオフとなります。
まずは AutoML の使用を検討し、AutoML でモデルの精度が上がらなかったり、AutoML を使用できない要件があったりする場合にカスタムトレーニングを使用するとよいでしょう。
- 参考 : トレーニング方法を選択する
| AutoML | カスタムトレーニング | |
|---|---|---|
| データサイエンスの専門知識 | 不要。 | 必要。 トレーニングコードの開発や、特徴量エンジニアリングなどのデータ準備を行う必要がある。 |
| プログラミングスキル | 不要。 | 必要。 トレーニングコードを開発する必要がある。 |
| モデルのトレーニングに要する時間 | 開発やデータ準備の必要がないため、短め。 | トレーニングコードの開発やデータ準備を行う必要があるため、AutoML と比べると長め。 |
| 機械学習の目標に関する制限 | AutoML で定義されている目標 のいずれかをターゲットにする必要がある。 | なし。 |
| パフォーマンス最適化のためのハイパーパラメータ調整 | できない。 自動でハイパーパラメータ調整が行われる。 |
できる。 |
| トレーニング環境の制御 | 制御できる要素が少ない。 トレーニングに使用するノード時間と早期停止 ( Early stopping ) の指定のみ可能。 |
制御できる要素が多い。 開発環境として使用する Compute Engine VM のマシンタイプ、ディスクサイズ、機械学習フレームワーク、ノード数などの要素を指定できる。 |
| データサイズの制限 | 制限あり。 Vertex AI で管理される マネージドデータセット を使用する必要があるが、データの種類によってサイズの制限がある(参考)。 (例)表形式データの CSV ファイルの場合:最大 100 GB |
制限なし。 マネージドデータセットを使用する場合のみ AutoMLと同様の制限あり。 |
構成要素
マネージドデータセット
マネージドデータセット(managed datasets)とは、機械学習モデルのために収集したデータを格納するオブジェクトです。データをマネージドデータセットとして登録すると、データを一元的に管理することが可能です。
マネージドデータセットのソースとしては、たとえば表形式データであれば、ローカル PC もしくは Cloud Storage にある CSV ファイル、BigQuery のテーブル、ビューから選択することができます。
マネージドデータセットはデータソースの URI を持ち、トレーニングの際にデータソースからデータがインポートされます。ローカル PC からデータをインポートした場合は、データは Cloud Storage に格納され、データセットにはその URI の情報が渡されます。
AutoML を使用する場合、まずマネージドデータセットを作成し、それをトレーニング時に読み込む必要があります。
トレーニング
トレーニング(Training)は、AutoML によるトレーニング、もしくはカスタムトレーニングを実行する際に作成するオブジェクトです。トレーニングにより開発されたモデルは、Vertex AI Model Registry で一元管理されます。
なお、Vertex Explainable AI を使用することで、トレーニングで作成したモデルの特徴アトリビューションの情報を得ることができます。
特徴アトリビューションは、各特徴(表形式データの場合はそれぞれの列)が予測にどの程度影響を及ぼしたかを可視化することができます。現在は表形式データ、画像データのモデルにおいてのみ使用することが可能となっています。

Vertex AI Model Registry
Vertex AI Model Registry では、作成した機械学習モデルを一元管理できるビューが提供されます。
ここでは Vertex AI で作成したモデルのほか、BigQuery ML や、Google Cloud 以外でトレーニングしたモデルをインポートし、バージョニング等の管理をすることができます。
Vertex AI Model Registry で管理しているモデルは、TensorFlow のパッケージとしてエクスポートすることができ、Google Cloud 以外の場所にもデプロイすることが可能です。
エンドポイント
エンドポイント(Endpoints)は、作成したモデルをデプロイし、オンライン予測のリクエストを処理する API エンドポイントです。
- 参考 : エンドポイントにモデルをデプロイする
1つのエンドポイントに対して複数のモデルをデプロイすることもでき、モデルごとにトラフィック転送の割合を指定できます。
これを利用することで、モデルの新しいバージョンをデプロイする際、同じエンドポイントにデプロイしてトラフィックの一部を割り当てることで、エンドポイントを新たに生成することなく、モデルをカナリアリリースすることも可能となります。
また、デプロイしたモデルに Vertex AI Model Monitoring を使用することで、オンライン予測の入力データから トレーニング / サービング スキュー や 予測ドリフト をモニタリングすることができます。
| モニタリング対象 | 説明 |
|---|---|
| トレーニング / サービング スキュー | 本番環境での特徴データの分布が、モデルのトレーニングに使用された特徴データの分布と異なることで、モデルの予測パフォーマンスが低下する現象。 |
| 予測ドリフト | 本番環境において、特徴データの分布が時間の経過とともに大きく変化してしまい、モデルの予測パフォーマンスが低下する現象。 |
Batch predictions
バッチ推論(バッチ予測、Batch predictions)では、モデルをデプロイすることなく、非同期リクエストによるバッチ予測を行うことができます。
- 参考 : Vertex AI での予測取得の概要
エンドポイントを使用したオンライン予測とは異なり、1回のリクエストで複数の予測用データを処理することができます。
バッチ予測では、モデルのタイプ(画像・動画・表形式など)に応じて、予測用データのソースと予測結果の出力先を選択します。
たとえば表形式データの予測では、データソースとしてローカルにある CSV ファイル、Cloud Storage にある CSV ファイル、BigQuery のテーブルやビューを選択でき、出力先には Cloud Storage 、BigQuery を選択できます。
Vertex AI に統合されたその他のツール
概要
Vertex AI に統合されている、モデル作成の効率化やモデル品質の継続的な改善のためのツールを、概要レベルで解説します。これらのツールは同じ Vertex AI の名前を冠していますが、それぞれ異なる役割を持っています。
これらは、Vertex AI という共通のブランディングを持っていながら、別々のツールであると考えることができます。
Vertex AI Workbench
Vertex AI Workbench は、機械学習モデルを作成するための Jupyter Notebook ベースの開発環境を提供するマネージドサービスです。
環境は JupyterLab でパッケージ化されており、TensorFlow や PyTorth などの各種機械学習フレームワークがプリインストールされています。
Vertex AI Workbench を利用することで、BigQuery や Cloud Storage のデータへのアクセス、BigQuery のクエリ発行、Vertex AI パイプラインの構築と実行など、モデル作成に関する様々なタスクをすべてノートブック上で行うことができます。
詳細については以下の記事でも解説しています。
Vertex AI Feature Store
Vertex AI Feature Store は、機械学習に用いる特徴量(features)を一元化して管理するためのリポジトリを提供するマネージドサービスです。
特徴量を一元的に管理することで、組織内のモデル開発者ごとに特徴量の計算方法が異なったり、特徴量の情報が分散してしまったりすることを防ぎ、特徴量の共有・再利用を促すことができます。
また、Feature Store では特徴量の分布変化が監視され、トレーニング / サービング スキューや、予測ドリフトの回避に役立てることができます。
Vertex AI Feature Store では、特徴データは BigQuery のテーブルまたはビューで管理されており、BigQuery データソースから直接オンラインで提供することができます。
Vertex AI Pipelines
Vertex AI Pipelines では、データの前処理、データ変換、モデルのトレーニングなどをコンポーネントとしてパイプラインを構成し、オーケストレートするためのマネージドサービスです。
パイプラインは Kubeflow Pipelines SDK または TensorFlow Extended を使用して構築された、コンテナベースの機械学習ワークフローとして動作します。
Vertex ML Metadata や Vertex AI Model Monitoring などと併用することで、パイプラインを用いたモデルの迅速かつ継続的なデプロイと、モニタリングを通じたモデルの品質維持、改善による MLOps を実践することができます。
Vertex AI Pipelines の詳細については以下の記事でも解説しています。
Vertex ML Metadata
Vertex ML Metadata は、機械学習ワークフローによって生成されるデータセットやモデルなどのアーティファクト、実行、イベント、コンテキストなどのリソースに対して付与されるメタデータを管理するためのマネージドサービスです。
各リソースには ID や リージョンのほか、作成日、更新日、保存場所、リソースの作成に使用された要素などの Key-Value 形式のメタデータが付与されることに加え、モデルのリネージの分析や、実行されたパイプラインの追跡を行うことができます。
Vertex AI Experiments
Vertex AI Experiments は、モデルのアーキテクチャ、ハイパーパラメータ、トレーニング環境を分析して比較し、最適なモデルを選択するのに役立てることができるツールです。
モデルのトレーニングにおける入力(各種パラメータ)や出力(モデル精度の指標)、使用されたデータセットなどの組み合わせをテスト(experiment)という1つの単位としてまとめて追跡し、それぞれのテストを比較できます。
また、Vertex AI Pipelines との統合により、複数のパイプラインのテストを比較することも可能です。
テストの追跡、可視化には Vertex ML Metadata と、マネージドな TensorBoard インスタンスである Vertex AI TensorBoard が使用されます。
Vertex AI Vizier
Vertex AI Vizier は、ハイパーパラメータのチューニングを支援するツールです。
複雑な機械学習モデルのトレーニングにおいて、既知の目的関数(モデル予測で最大化 / 最小化したい関数。予測と正解のズレを表す評価関数など)がない場合や、目的関数を使用したモデルの評価が困難な場合に、ハイパーパラメータを自動で最適化するブラックボックス最適化が提供されます。
- 参考 : Vertex AI Vizier の概要
Vertex AI Vector Search
Vertex AI Vector Search は、ベクトル検索を自前で開発することなくシステムに組み込むことができるサービスです。
ベクトル検索は、YouTube や Google 画像検索、Google Play などのサービスでレコメンデーションや情報検索の際に使われています。情報を予めエンベディングと呼ばれる数列に変換して格納しておくことで、文字列一致ではない、意味に基づいた検索が可能になります。
Vertex AI Model Garden
Vertex AI Model Garden は、機械学習モデルなどの製品をカタログ形式で閲覧でき、購入できるプラットフォームです。様々なタスク、データセットに対応した 100 以上のモデルが Google やサードパーティによって提供されています。
Model Garden により、Gemini などの Google が提供するモデルのみならず、Claude や Llama などのサードパーティのモデルも、Google Cloud(Vertex AI)経由で利用することができます。
Model Garden で利用可能なモデルは以下の 3 カテゴリに分類されます。これらのモデルは、タスクに合わせてカスタマイズできるものや、特定のタスクであればそのまま使用できるものがあります。
| カテゴリ | 説明 |
|---|---|
| Foundation models(基本モデル) | 事前トレーニングされた大規模モデルで、Generative AI Studio、Vertex AI API、Vertex AI SDK for Python を使用することで、特定のタスクに合わせてカスタマイズできる。 |
| Fine-tunable models(ファインチューニング可能なモデル) | カスタムノートブックやパイプラインを使用してファインチューニングができるモデル。 |
| Task-specific solutions(タスク固有のソリューション) | すぐに使用することができる事前構築済みモデル。独自のデータを使用してカスタマイズできるものを含む。 |
Colab Enterprise
Colab Enterprise は、Vertex AI に統合されたマネージドな Google Colaboratory 環境です。インフラストラクチャの管理をすることなく、Jupyter ノートブック上で開発や作業を行うことができます。
ランタイム という単位でノートブック内のコードを実行する仮想環境(VM)が起動され、マシンタイプに応じた時間料金が発生します。ランタイムは使用していないときに自動でシャットダウンし、コストを節約することができます。
また、ノートブックでは Gemini によるコード補完を利用することができます。
- 参考 : Colab Enterprise の概要
詳細については、以下の記事で Vertex AI Workbench との比較とともに解説しています。
佐々木 駿太 (記事一覧)
クラウドソリューション部 クラウドエンジニアリング1課
北海道在住
大学院まで社会心理学を専攻し、AI に興味を持ち IT 業界へ。2022年6月に G-gen にジョイン。Google Cloud Partner Top Engineer に選出(2024 / 2025 Fellow / 2026)。好きな Google Cloud プロダクトは Cloud Run。
趣味はコーヒー、小説(SF、ミステリ)、カラオケなど。最近は時計と007(映画)がマイブーム
Follow @sasashun0805