


G-gen の杉村です。当記事では、生成 AI 技術を利用した検索エンジンやエージェント開発のための Google Cloud プロダクトである Agent Search(旧称 Vertex AI Search)を解説します。
概要
Agent Search とは
Agent Search(旧称 Vertex AI Search)は、PDF や Word ドキュメントなどの社内情報や、外部の Web サイトに対する検索機能を提供するフルマネージドなプラットフォームです。Google Cloud のプロダクトの1つとして提供されています。
Agent Search を使うことでセマンティック検索(意味論検索)を容易に実装でき、Google ドライブや BigQuery、Cloud Storage に格納された構造化データや非構造化データに対して検索できるほか、ウェブサイトに対する検索を実施できます。
また Agent Search は生成 AI と統合されており、検索結果の要約や、ユーザーの自然言語による質問に答えることができます。
Agent Search はフルマネージドサービスとして提供されており、インフラの構築や運用を意識する必要がありません。また、API 経由で自社の Web サイトやアプリケーション、チャット等から呼び出して利用できます。開発用の Web UI(Google Cloud コンソール)が用意されており、設定や調整、動作確認はこの画面から行うことが可能です。
なお Google Cloud コンソールの管理画面上では、「Agent Platform > エージェント > 検索」から当プロダクトを管理できます。
- 参考 : Agent Search の概要
RAG の実現
RAG とは Retrieval Augmented Generation の略称であり、生成 AI によるテキスト生成などに、外部データソースを用いて情報の根拠付けを行うアーキテクチャのことです。
生成 AI が誤った情報を生成してしまうことを「ハルシネーション」と言います。RAG アーキテクチャでは、インターネットの Web サイトや事前に準備したドキュメント集などをデータセットとして、生成する情報に組み込んだり脚注のような形で参考情報として添付することでハルシネーションを軽減します。
Vertex AI Search では、Web サイトや PDF、Word ファイル、パワーポイントのスライドなどをデータストアとする RAG 構成を容易に構築できます。
なお Web サイトをデータストアとする場合、Vertex AI Search で要約文を生成するには当該 Web サイトのドメイン認証(DNS レコードを追加する等)が必要ですが、以下の記事のように、LangChain 等を用いて自前で実装することでドメイン認証なしで実現することもできます。
名称の変遷
Agent Search の名称は、繰り返し変更されてきました。名称の変遷は以下のとおりです。
| 名称 | 時期 | 備考 |
|---|---|---|
| Generative AI App Builder | 2023-03-29 | Preview 公開。略称 Gen App Builder |
| Vertex AI Search and Conversation | 2023-08-29 | 一般公開 (GA)。Vertex AI Search と Vertex AI Agents の2機能を含む |
| Vertex AI Agent Builder | 2024-04-24 | 改名のみ |
| AI Applications | 2025-04-02 | 改名のみ |
| Vertex AI Search | 2025-10-02 | Vertex AI Agents が分離され Vertex AI Search が単独プロダクト化 |
| Agent Search | 2026-04-22 | Vertex AI が Gemini Enterprise Agent Platform に改称したのに伴い Vertex AI Search も Agent Search に改称 |
これらの名称変更により、ドキュメントやコンソール上の表記が変更されましたが、API エンドポイント名(discoveryengine.googleapis.com)等は変更されません。また IAM ロール名や API 名などは、Discovery Engine(ディスカバリーエンジン)という名称が使われています。これらはすべて、同じものを指していると考えて差し支えありません。
- 参考 : Vertex AI Search release notes - August 29, 2023
- 参考 : Vertex AI Search release notes - April 24, 2024
- 参考 : Vertex AI Search release notes - April 02, 2025
- 参考 : Vertex AI Search release notes - October 02, 2025
- 参考 : Vertex AI Search release notes - April 22, 2026
公式ドキュメントや解説動画、パートナー各社の資料やブログ記事などには、旧来の名称で記載されていることがあります。
ユースケース
社内検索エンジン
この例は、Agent Search を使った社内検索エンジンです。テキストや Microsoft Word で作成された社内ドキュメントをデータソースとして、社内従業員向けのポータルサイトから利用します。
このツールでは、人間が普段使うような自然言語を使った検索ができます。また結果の返答には、AI によって生成された質問に対する回答の要約や、対象ドキュメントへのリンクを含ませることができます。一度質問したことに対して、追加質問を重ねて行うようなフォローアップ検索を行うこともできます。

顧客対応補助
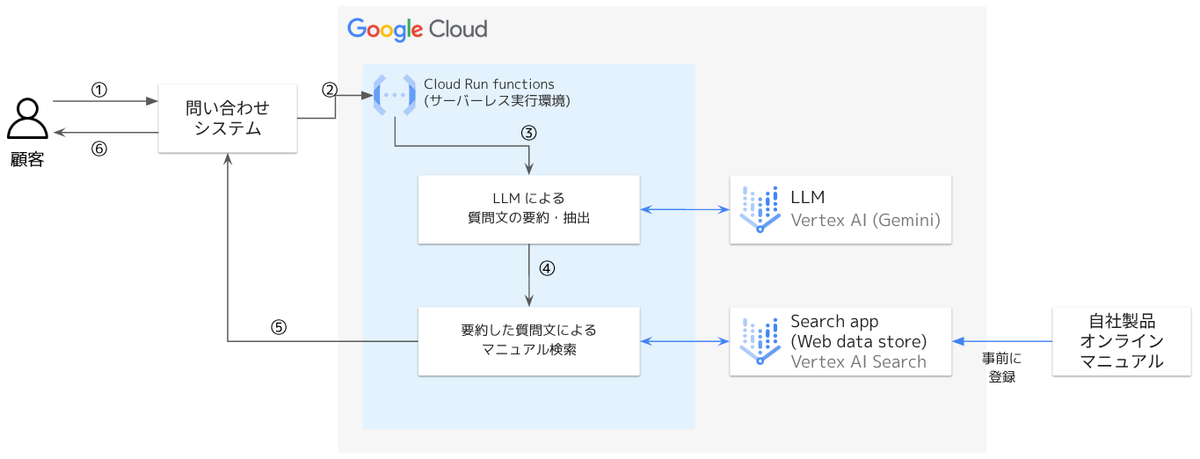
以下の例は、Agent Search と、Vertex AI による Gemini API の呼び出しと組み合わせることで、顧客からの問い合わせ業務を補助する仕組みを示しています。
AI エージェントのバックエンド
AI エージェントとは、生成 AI が複数ステップのタスクをこなし、人間の代わりに仕事をする仕組みのことです。Agent Search は、AI エージェントを構成する部品の1つとして使用することができます。
以下の記事は、G-gen が提供する AI エージェントサービスのアーキテクチャについての解説です。バックエンドに Agent Search を使用しています。
料金
クエリ料金とエディション
Agent Search では、クエリ回数に対する従量課金が発生します。また、利用するオプション機能ごとに単価が異なります。これに加えて、いずれの機能でもデータインデックス料金が発生します。これは回答に用いる根拠データとして取り込んだデータの容量に応じて課金されます。
クエリ回数の料金単価は、作成した検索アプリで Search Standard Edition を選ぶか、Search Enterprise Edition を選ぶかによって異なります。
| エディション | 検索機能 | AI 機能 | 単価 |
|---|---|---|---|
| Search Standard Edition | ・構造化データストアに対する検索 ・非構造化データストアに対する検索 |
なし | $1.50 / 1,000 クエリ |
| Search Enterprise Edition | ・構造化データストアに対する検索 ・非構造化データストアに対する検索 ・Web データストアに対する検索 |
・回答や要約の生成 ・フォローアップ検索 |
$4.00 / 1,000 クエリ |
さらに上記に加えて、アプリで Advanced Generative Answers を有効化すると、上記に加えて $4.00 / 1,000 クエリの料金が加算されます。Advanced Generative Answers では、フォローアップ検索のサジェスト、クエリの自動書き換えなどの複雑なハンドリング、マルチモーダル機能などが含まれます。例えば、Search Enterprise Edition のアプリで Advanced Generative Answers を有効化すると、クエリ単価は $8.00 / 1,000 クエリとなります。
上記の表は、2025年6月現在のものです。最新の料金単価は、以下の公式ページを参照してください。Vertex AI Search の料金はたびたび改定されており、最新の情報を得るには英語版のページを見ることが推奨されます。日本語版ページは、遅れて翻訳される可能性があります。
- 参考 : Agent Search pricing
インデックスストレージ料金
加えて Agent Search では、インデックスストレージの保管料金が発生します。
Agent Search でデータストアを作成すると、内部的なインデックスデータベースにデータが登録されます。このインデックスストレージの保管料金が発生します。2025年6月現在の単価は、$5.00 / GiB / 月 です。インデックスのリフレッシュはコストに影響しません。
また Web サイトデータストアの場合、この容量は「500 KiB × ページ数」で計算されます。
無料枠
請求先アカウントごとに、無料で毎月10,000クエリを実行できます。
さらにインデックスストレージ料金には、毎月 10 GiB の無料枠が用意されています。
構成可能な料金(Configurable pricing)
月間1500万クエリを超える、特に利用ボリュームの多いワークロード向けに、Agent Search では 構成可能な料金(Configurable pricing)という料金体系も用意されています。
検索クエリ料金とインデックスストレージ料金のそれぞれに対して、月額サブスクリプション形式での支払を設定することで、コスト最適化を図ることができます。
- 参考 : カスタム検索の構成可能な料金を設定する
検索・要約機能の概要
検索と要約
Agent Search では、BigQuery テーブルに格納された構造化データや、Cloud Storage や Google ドライブに格納された TXT、HTML、PDF、docs、pptx、xlsx などの非構造化データに対して検索を実行できます。
検索はセマンティック検索で行われます。セマンティック検索は意味論検索とも呼ばれ、文字列一致ではなく、言葉の意味を捉えた検索のことです。Agent Search ではデータストアと呼ばれるデータベースに、ベクトル化されたデータソースのデータをインデックス情報として格納して、これに対して検索を実行します。
また Google 検索のように、キーワード検索、画像検索、検索キーワードのオートコンプリートやスニペット表示ができるほか、利用者の検索傾向を分析する機能なども備えています。
Agent Search の検索機能は Web API 経由で呼び出すことができるため、上記のような高度な検索機能を、簡単に自社サイトやアプリケーションに組み込むことができます。

要約
Agent Search は生成 AI モデル Gemini と統合されており、検索結果から要約や質問に対する回答を生成したり、フォローアップ検索(深堀り質問)を行うことができます。
社内ドキュメントなどを Cloud Storage に格納しておき、これを Agent Search のデータストアとして登録しておくことで、「当社の有給休暇の付与日数は?」といった質問に答えさせることができます。
また、情報の引用元を明示させることができます。

対応言語
日本語、英語、フランス語、スペイン語、ポルトガル語、ヒンディー語などの言語に対応しています。
日本語は2026年7月現在、Healthcare search を除いたすべての機能でサポートされています。
- 参考 : Languages
検索・要約機能の詳細
オートコンプリート
Agent Search では、Google 検索のような検索キーワードのオートコンプリート(予測入力)を有効化できます。
データストアが構造化データや非構造化データの場合は、データストア内のドキュメントに基づいてオートコンプリートが生成されます。データストアが Web サイトの場合は、過去の検索履歴から生成されます。過去履歴の反映は利用開始から数日かかります。
- 参考 : 予測入力を設定する
スニペットと抽出コンテンツ
Agent Search ではスニペットや抽出回答(Extractive answers)、抽出セグメント(Extractive segments)を返すこともできます。
スニペットは、各検索結果の下に表示される、ドキュメントの抜粋です。
抽出回答(Extractive answers)は、検索結果から関連性が高い一部分を抜粋したものです。Google 検索でいうところの「強調スニペット」がこれにあたり、検索結果の中でも最も関連性が高いと思われるドキュメントの一部抜粋を最上部に表示しています。
抽出セグメント(Extractive segments)は、抽出回答よりさらに長く抜粋したもので、LLM にインプットして新たな回答文を生成する時などに用います。
以下のスクリーンショットは Agent Search ではありませんが、参考として Google 検索でスニペットや抽出回答がどの部分に当たるかを示したものです。
- 参考 : スニペットと抽出コンテンツを取得する

検索結果の要約
検索結果の要約(search summary)を有効化すると、上位の検索結果をサマリして検索結果として表示する機能です。要約は前述の抽出回答(Extractive answers)から生成されます。
要約には引用元(Citations)ドキュメントを明示させたり、情報サイトを求めるだけでサマリを作るべきではないクエリにはサマリを返さない、脚注に情報ソースを表示など、豊富なオプションがあります。プロンプトを挿入して、要約結果をカスタマイズすることも可能です(Customized summaries)。
当機能の利用には、アプリで Search Enterprise Edition を有効化する必要があります。また Web サイトへの検索の場合は、データストアで Advanced website indexing の有効化が必要であり、対象 Web サイトのドメイン認証が必要になります(後述)。
- 参考 : 検索の要約を取得する
フォローアップ検索
フォローアップ検索(Search with follow-ups)は生成 AI の機能を活かしてより先進的な検索を行う機能です。以下が含まれます。
- Natural language query processing : 自然言語による質問文の意図を汲んで検索結果を返す
- Context awareness : 先の質問を背景として考慮に入れて回答する
- Multi-turn(マルチターン): ある質問に続けて追加の質問が可能
すなわち以下のようなやりとりができることであると、公式ドキュメントでは示されています。
あなた : メキシコで休暇を過ごすのにベストな時期はいつ?
フォローアップ検索 : メキシコでの休暇に最適な時期は、11月から4月の乾季です。
あなた : 為替レートはいくら?
フォローアップ検索 : 1USD は約17.65メキシコペソです。
あなた : 12 月の平均気温は何度?
フォローアップ検索 : 平均気温は70~78°F の範囲です。カンクンの平均気温は約77°F です。
フォローアップ検索を利用するには、アプリで Search Enterprise Edition の有効化が必要です。
また、フォローアップ検索のサジェスト(提案)を表示させることもできます。

アプリとの統合
API による独自アプリとの統合
Agent Search には API が用意されており、独自開発したアプリケーションから API を呼び出すことで、検索結果を得たり、AI による回答を得ることができます。
ドキュメントの検索結果を得る search メソッドや、検索結果と AI による回答の両方を得る answer メソッドなどが用意されています。
- 参考 : 検索結果を取得する
- 参考 : 回答とフォローアップを取得する
ウェブサイトへのウィジェット追加
Agent Search を使った検索結果を得るには、前述の API へリクエストする方法のほか、JavaScript でウィジェットとして埋め込む方法もあります。
Agent Search の開発 UI から、自社ウェブサイト等に簡単にウィジェットを追加するための JavaScript コードを得ることができます。
ウィジェット方式では JWT または OAuth による認証をかけるか、公開検索エンジンとするかを、アプリごとに選択可能です。
さらに許可対象とする呼び出し元ドメイン名もホワイトリスト登録できます。
- 参考 : 検索ウィジェットをウェブページに追加する

分析
Google Cloud コンソールの分析画面では、検索の回数、クリックスルーレート(CTR)、デバイス情報などの分析情報を確認することができます。
- 参考 : アナリティクスを見る
オプション
Search Enterprise Edition
Agent Search アプリを作成する際に、Search Enterprise Edition(Enterprise エディションの機能とも)を有効化することができます。アプリ作成時に有効化を選択できるほか、アプリ作成後の変更も可能です。なお、ウェブサイト検索を行うには Search Enterprise Edition の有効化が必須です。
Search Enterprise Edition を有効化すると、以下の機能を利用できます。
- 検索結果から要約の生成
- フォローアップ検索
- 抽出回答(Extractive answers、Extractive segments)
- ウェブサイト検索
Search Enterprise Edition を有効化すると、クエリあたりの料金単価に追加料金が加算されます。
- 参考 : Agent Search pricing
Advanced Generative Answers(高度な LLM 機能)
Agent Search アプリを作成する際に Advanced Generative Answers(高度な生成回答、もしくは高度な LLM 機能とも)を有効化することができます。作成後に変更することも可能です。
Advanced Generative Answers を有効化すると、フォローアップ検索のサジェストや、複雑なクエリのハンドリングが利用可能になります。ただし、クエリあたりの料金単価に追加料金が加算されます。

なお2025年5月の料金改定前は、このオプションは LLM アドオンの Basic(基本)および Advanced(上級者向け)という2つのオプションとして用意されていました。料金改定に伴い、Advanced Generative Answers として一本化され、またクエリ単価も値下げされました。
機能と対応するオプション
ある機能を使うためにどのオプションを有効化する必要があるかは、以下のドキュメントに表でまとめられていますので、ご参照ください。
- 参考 : 高度な機能について
アプリとデータストア
アプリ
Agent Search の設定はアプリ(Apps)というリソースで管理され、それぞれのアプリが使うデータはデータストアというリソースとして管理されます。
アプリ(Apps)は「カスタム検索アプリ」「ウェブサイト検索アプリ」など、機能を選んで作成する、ひとまとまりの設定単位です。
例として、カスタム検索アプリを作成するときは、アプリ名やエディション、有効化する検索機能(オートコンプリートや LLM による要約など)、検索対象のデータストア、などを選択します。

データストア
Agent Search は、データストアとして取り込んだ情報を基に、利用者からの質問に答えたり、検索を行ったり、エージェントとしてタスクを行ったりします。

データストアにはウェブサイト、テキストドキュメントなどを取り込むことが可能です。より正確には、以下のようなフォーマットのデータを取り込み可能です。
| データストアタイプ | フォーマット | 取り込み方式 |
|---|---|---|
| Web | HTML / PDF | ドメイン名や URL で指定。Google Search Index で収集 |
| 非構造化データ | HTML / TXT / JSON / XHTML / XML / PPTX / DOCX / XLSX / PDF | Cloud Storage または API 経由でアップロード |
| 構造化データ | CSV / JSONL / BigQuery table | Cloud Storage、BigQuery、API 経由でアップロード |
- 参考 : アプリとデータストアについて
- 参考 : 取り込み用にデータを準備する
Web データストア
Web タイプのデータストアは、その名の通り Web サイトを取り込むためのデータストアです。Web サイト内の HTML のほか、PDF ファイルもインデックスされます。サイト全体を取り込むことも、一部を指定して取り込んだり、逆に一部を除外することもできます。
Google が検索エンジンに Web サイトを取り込むときに用いる「Google Search Index」と同じ仕組みで情報が収集されるため、Web サイトはインターネットからアクセスできる必要があります。
また Advanced website indexing(ウェブサイトの高度なインデックス登録)を有効化することで、検索結果の要約やフォローアップ検索等を実現できます。これを有効化するにはサイトの正当な所有者であることを示すためドメインの認証が必要です。ドメインの認証には Google 検索の最適化にも使われる Google Search Console と呼ばれる Google の Web ツールを使います。「ドメインの DNS ゾーンに指定の TXT レコードを追加する」「ページに Google Analytics のトラッキングコードを挿入する」「HTML ファイルを特定 URL にアップロードする」などの方法でドメイン認証を行うことができます。ドメイン認証は、Advanced でない通常のインデックス作成であれば不要です。
構造化データストア
構造化(Structured)タイプのデータストアは、FAQ(よくある質問)や商品カタログ等を取り込むために用います。
構造化データストアの作成時は、BigQuery テーブルか、JSON(NDJSON/JSONL)形式で Cloud Storage バケット上にデータを用意します。また、API 経由でデータを投入することも可能です。スキーマは自動検知させることも、明示的にスキーマ情報を与えることもできます。
ただし BigQuery の外部テーブルをデータストアとして取り込むことはできませんのでご注意ください。
非構造化データストア
非構造化(Unstructured)タイプのデータストアは、PDF や HTML、TXT ファイル等をファイルとして直接取り込むためのデータストアです。また PPTX(PowerPoint)や DOCX(Word)、XLSX(Excel)などの形式にも対応しています。
ファイルは、原則として Cloud Storage バケット経由でアップロードします。アップロードするファイルには「タイトル」と「URL」をメタデータとして付与することができ、付与した場合はチャットボットが利用者に返答する際に、その URL を添付して回答することができます。これにより利用者は、インターネットに接していない内部 Web サイトを情報源として参照することができます。
データストアへの取り込み指示は、メタデータ無しの場合は単純に Cloud Storage バケットやそのパスを指定します。メタデータ有りの場合は、取り込み対象ファイルの Cloud Storage URL とメタデータ情報を JSONL 形式で記述したり、BigQuery テーブルに格納して、これに対して取り込みを指示します。
非構造化データのパース(解析)
Agent Search では非構造化データとして Cloud Storage に PDF ファイル、HTML ファイル、docx ファイル、pptx ファイル、xlsx ファイル、txt ファイル等を検索対象とすることができます。これらのファイルを配置した非構造化データストアを作成する際に、パーサーと呼ばれるファイルをパース(解析)するための処理の種類を選択できます。パーサーには以下の種類があります。
| パーサー名 | 対応フォーマット |
|---|---|
| デジタルパーサー (Digital parser) |
HTML、PDF、docx、pptx、txt、xlsx |
| PDF の OCR 解析 (OCR parsing for PDFs) |
|
| レイアウトパーサー (Layout parser) |
HTML、PDF、docx、pptx、xlsx |
デフォルトではデジタルパーサーが選択されます。デジタルパーサーは、ファイルにデジタル情報として格納されたテキストを検出し、段落情報を検知することができます。
もし PDF が手書きの文字をスキャンしたものであれば、OCR パーサーを選択して文字を読み取ることができます。
レイアウトパーサーを選択した場合は、ファイルから段落、表、画像、タイトル、見出し要素等が検出されます。レイアウトパーサーを選択するには、 ドキュメントのチャンク化(document chunking for RAG)を有効化する必要があります。ドキュメントのチャンク化を有効化すると、ファイルは非構造化データストア内でチャンク化(ファイルを分割して細かい情報にすること)されます。これにより、データストアは RAG に最適化されます。また Gemini レイアウト解析を有効化すると、PDF ファイルの解析に生成 AI モデル Gemini が使用され、品質向上が期待できます。
- 参考 : アプリとデータストアについて - 非構造化データ
- 参考 : ドキュメントを解析してチャンク化する
杉村 勇馬 (記事一覧)
執行役員 CTO
元警察官という経歴を持つ IT エンジニア。クラウド管理・運用やネットワークに知見。AWS 認定資格および Google Cloud 認定資格はすべて取得。X(旧 Twitter)では Google Cloud や Google Workspace のアップデート情報をつぶやいています。
Follow @y_sugi_it